70 元做一台「刷短剧神器」:我用ESP32-S3 语音手势控制,再也不用手指滑动了
- 2026-11-20 14:51:56
70 块钱的一套零件,让我洗碗的时候也能追剧
那个让我破防的夜晚
去年冬天,我在洗碗。
手机架在灶台边上,正放着一部短剧。水哗哗地流,剧情正到要紧处——广告插进来了。
我手上全是洗洁精泡沫。
得先说清楚一件事:红果这类短剧 App 本来就会自动连播下一集,这不是问题。真正麻烦的是中间那段广告——要么杵在那儿等倒计时走完,要么伸手把它划走。还有时候片尾卡一下,它就是不往下跳,非得推它一把。
于是我做了一整套动作:关水 → 抽纸巾擦手 → 拿起手机 → 用还能动的那根手指滑一下 → 放下手机 → 重新开水 → 继续洗。
一集三分钟,中间插一段广告,一个晚上这套动作能重复十几次。到后来我干脆不洗了,站在水池边等手干。
那天晚上我想明白一件事:
就一句话的事,为什么要用手。
同样的场景还有很多。冬天窝在被窝里,手机架在床头,手伸出来那一下就冷得清醒;手上沾着面粉在揉面;抱着孩子腾不出手;敷着面膜不想动脸;举铁举到一半……
这些时候,你缺的不是一个更灵敏的屏幕,是一双手。
于是有了这个东西
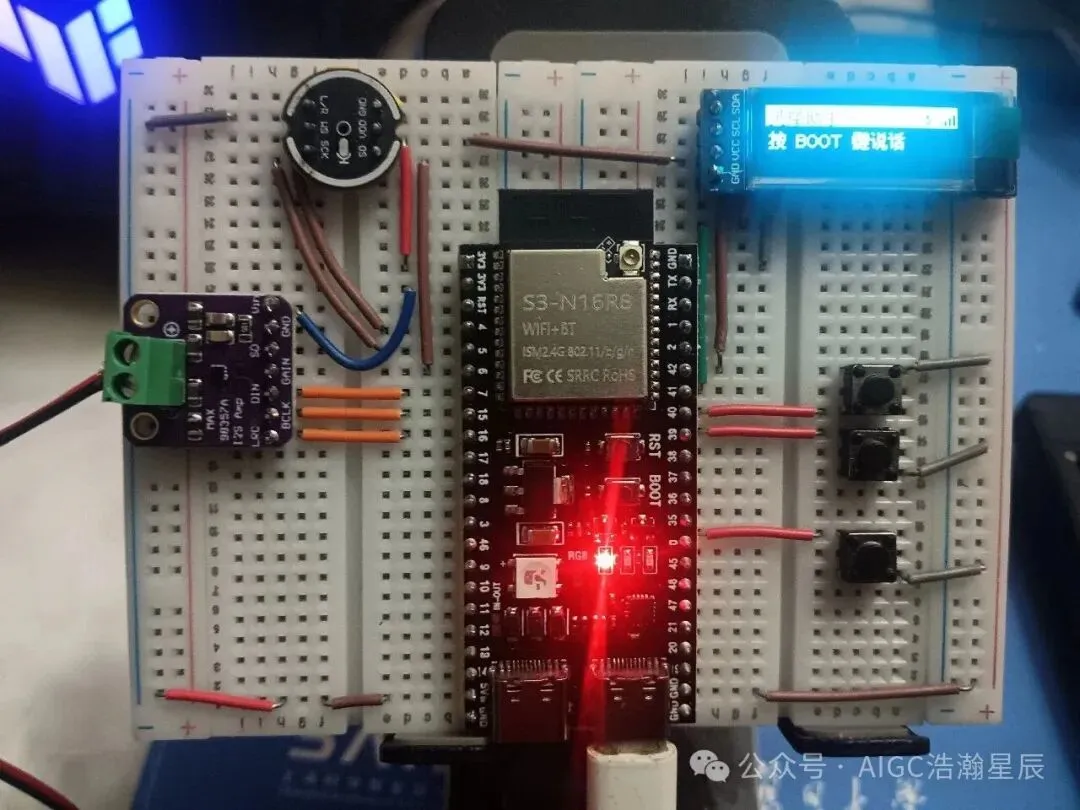
现在它长这样:桌上一块巴掌大的板子,接一个小麦克风、一个小功放、一块 0.91 寸的屏幕。
我对着它说两个字:
「上滑。」
两秒钟后,手机屏幕亮了——广告被划走,短剧接着往下播。
不是手机听见的。是这块板子听见的——它先听懂了我的话,然后冒充一个蓝牙触摸屏,替我的手指在屏幕上划了一下。
抖音、红果短剧、快手,只要能上下滑的,都能这么翻。
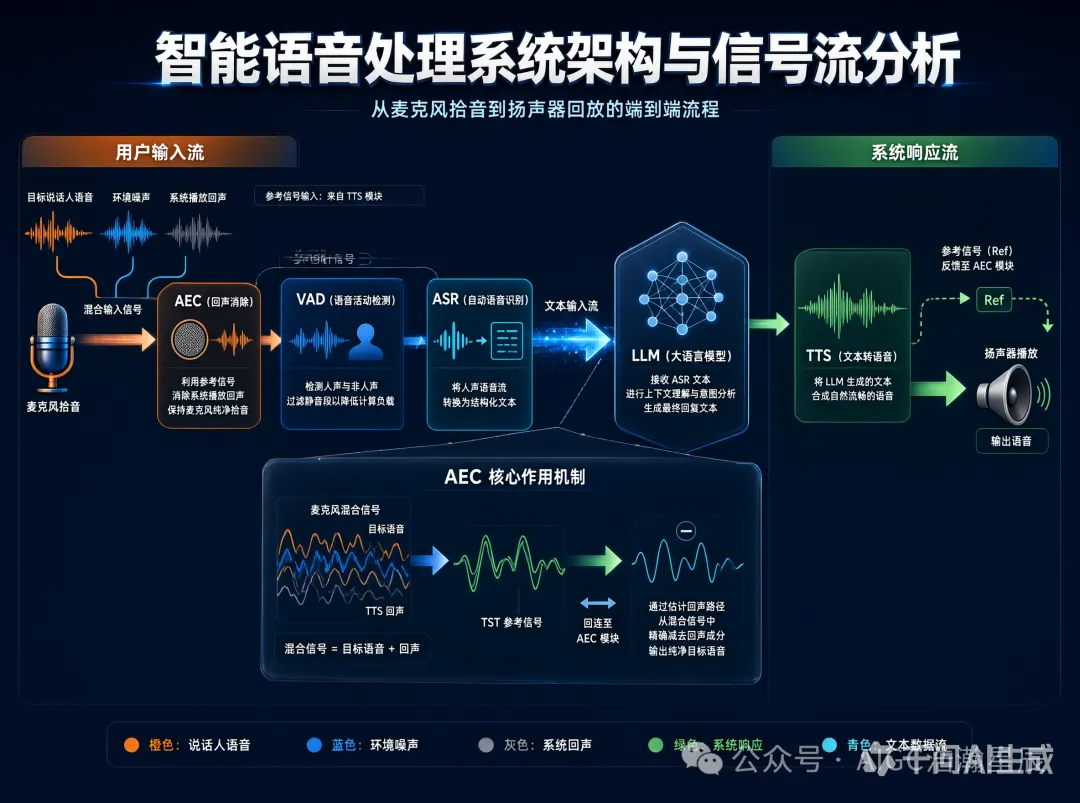
它也不只是个翻页器。你问它「明天多少度」「讲个笑话」,它照样答,回答也是语音播出来的——底下是一整条自己的语音链路,从听清到想明白再到开口。
整套成本 70 多块。
那天我把手在围裙上随便抹了两下,说了句「下一集」,然后接着洗碗。那一下的爽感,比做出这个东西本身还强。
一、为什么市面上买不到,只好自己做
我认真找过。
语音助手一堆,但没有一个能控手机——它们只会陪你聊天、放音乐、开关灯。因为「控制另一台手机」这事儿在厂商眼里没有商业价值:你手指滑一下又不费劲。
可对我来说,费劲的从来不是「滑一下」,是「手上有水」。
开源方案里最成熟的是小智 AI,硬件方案和驱动代码都很完整——我这个项目的硬件驱动层就是从它那儿学的,这点得说清楚,不是从零造轮子。
但它走的是官方云服务,而且没有「控手机」这一层。「控手机」这层没有现成的,只能自己写。
关于云服务,我想多说两句,因为这是被问最多的:
一句话里,藏的东西比你以为的多。不只有内容,还有你的声纹、你的语气、你家厨房在炒什么、客厅电视在放什么、你几点还没睡。走云服务,这些原始音频是要整段经过别人服务器的。我不是说谁不安全——只是这种事,我更愿意放在自己家里。
所以我自己写了后端:语音识别、大模型、语音合成,全部跑在自己机器上。用手机热点那套方案的时候,除了问大模型那一步,整条链路都在我家局域网里,录音和回复一个字节都不出网。
第二个理由是:云上你只能用它给的东西。我想换识别模型、想换合成音色、想把灵敏度调到我这个房间刚好合适——在自己代码里都是改一行的事。
第三个理由是私心:我想知道它到底怎么工作的。为什么整段上传不卡?为什么门限要用中位数?这些问题跑在别人的云上,永远只能看到「能用」,看不到「为什么」。
当然代价也有:服务器要自己维护,环境要自己装,出问题没人帮你查。如果你只是想要个能聊天的音箱,买成品或者用小智的方案,都比自己做理性得多。
代价认了,那就开工。
我想验证的事情很简单:
一条完整的语音链路——听清、想明白、做出来——能不能全部跑在自己的一台机器上,整套硬件压到 100 块以内。
后来做到了 70 多。
二、它现在能干什么
说一句就翻页。「上滑」「下滑」,短剧和抖音跟着走。广告来了划一下,卡住了推一把,全程不用碰手机。手机跟它配对一次,之后自动连。
不用按键。长按 2 秒打开「常开聆听」,之后不用碰它,直接说就行。洗碗、做饭、躺被窝,手都不用伸出来。
屏幕有反馈。0.91 寸的小屏上显示「正在听」「正在想」「正在说」,回复的文字分页滚动,底下一条播放进度条。
不用重新烧录就能改配置。换 WiFi 了?设备自己开个热点,手机连上去自动弹出配置页,改完保存重启,完事。
不只能翻页,也能聊天。问天气、问时间,让它讲个笑话、解释个词,回复都是语音播出来的。这两件事走的路不一样:翻页是「指令」,听清就直接执行,跳过语言模型,三秒出头就能动;聊天是「对话」,要过大模型,慢个一秒多,但什么都能问。
三、踩过的坑,才是这个项目真正的内容
做硬件项目,写代码大概占三成,剩下七成在跟「为什么它不按我想的来」搏斗。
下面这三个坑,每一个都让我怀疑过人生。
坑一:它听得见,但永远不开口
常开聆听做出来那天,我兴冲冲打开,对着它说了句话。
没反应。
又说了一句。还是没反应。
但校准日志明明显示成功了:底噪多少、门限多少,都算出来了,打印得清清楚楚。
问题出在「判定」这一步。
我原来的逻辑是:连续 7 帧能量超过门限,才算「开始说话」。
听起来很合理,对吧?
但我算了一下:每帧 64 毫秒,7 帧就是 448 毫秒。也就是说,这 448 毫秒里每一帧都必须超过门限,中间掉一帧就清零重来。
中文说话是什么节奏?「今天——天气——怎么样」——字和字之间必然有几十毫秒的气口,说完一个词还要换气。
于是计数器永远在「攒到 3、掉回 0、攒到 4、掉回 0」之间循环,一辈子攒不到 7。
改法很朴素:别清零,掉一帧就退一格。
像一个漏水的水桶,只要进水比漏水快,水位就会慢慢涨上去。同时把阈值从 7 帧降到 3 帧(约 190 毫秒)。
改完之后,正常语速说话,一次就触发。
这个道理我后来发现到处都适用:任何要求「连续 N 次全部满足」的判定,在真实世界的噪声面前几乎都是不可用的。
坑二:本地好好的,放到服务器上全是噪声
这个坑最诡异。
同一份代码,服务器跑在自己电脑上,回复的声音清清楚楚。部署到云主机上,播放出来全是刺耳的电流声。
我第一反应是「服务器生成的 WAV 有问题」。下载下来一听——好得很。用音频软件打开,波形漂亮,采样率也对。
文件没问题,网络没问题,程序一行没改。
那问题在哪?
在下载音频的那段代码里。
固件是边收边拼的:每次从网络读一块数据,就把这块数据当成音频采样存进缓冲区。原来的写法是:
int n = got / 2; // 收到多少字节,除以 2 得到多少个采样memcpy(buf + pos, data, n*2); // 拷过去
问题在于:got 是这一次实际收到了多少字节。TCP 分片是随机切的,它经常是奇数。
奇数除以 2,多出来的那 1 个字节就被丢掉了。而读取位置已经越过了它。
从这一刻起,后面每一个 16 位采样的高字节和低字节,全部错位一格。
对音频来说,错位一格 = 完全乱码 = 噪声。
为什么本地正常?因为本地网速快,数据整块到达,分片长度大多是偶数。
为什么远端就崩?因为链路慢,数据被切得又碎又小,奇数长度频繁出现。
同一份「正确」的代码,在两种网络条件下表现完全不同——这才是最难查的那类 bug。
修法是把那个孤立的字节留到下一批再拼,绝不丢弃。
坑三:加了个蓝牙,板子开始无限重启
BLE 手势功能写完,烧进去,板子开始循环重启。
日志是这样的:
Malloc failedesp_bt_controller_init -4StoreProhibited
翻译过来:内存分配失败 → 蓝牙控制器初始化失败 → 访问了空指针 → 崩。
我一开始以为是「蓝牙太吃内存,那少开点功能」。查下去才发现,凶手是我自己。
固件里有两个音频缓冲数组,一个录音用一个播放用,加起来192 KB。它们被声明成静态数组,编译时就被塞进内部 DRAM。
而蓝牙控制器启动时,需要一次性申请 40~60 KB 的连续内存块。
内部 DRAM 一共就那么大,被我这 192 KB 死死占着,剩下的全是碎片。蓝牙一看:连续块不够,返回失败。程序没检查返回值,接着用了空指针,崩。
三处一起改:
那 192 KB 改成从 PSRAM 分配(板子上有 8 MB PSRAM,本来就是干这个的); 蓝牙初始化提到 WiFi 之前(WiFi 协议栈一起来会吃掉一大块); 启动前先量一下最大的连续空闲块,不够 60 KB 就整个跳过蓝牙功能。
第三点是后来才想明白的:功能可以降级,程序不能崩。尤其是给普通人用的设备,你没法指望他们去看串口日志。
四、还有几个坑,一句话说完
「门限」怎么算,决定了它灵不灵。
一开始我用环境噪声的「峰值」乘 2.5 当作说话门限。结果校准那一秒里,只要有了一声咳嗽、一次碰桌子、风扇启动一下,峰值就被顶到天上,门限跟着被抬到正常说话永远够不着的高度。后来改成取中位数——中位数对单帧尖峰免疫。
烧完程序就自动静音。
每次刷完固件,串口都会打印「已静音」。查时间戳:开机 12.335 秒,静音在 14.338 秒——正好差 2.003 秒,而长按判定是 2000 毫秒。
真相是某个按键引脚上电后一直是低电平(硬件问题),而按键状态机的初始值被硬编码成了「高电平」,于是第一次轮询就判定「这个键被按下了」,一直按着,2 秒后触发长按。而音量减的长按正好是静音。
翻页不是速度问题。
为了调好「上滑」,我写了个脚本跑 8 组不同参数组合。结论很反直觉:速度、步数、按住时长全都不影响;唯一决定能不能翻页的,是手指划过的距离占屏幕的百分比。40% 怎么都不翻,55% 必翻。现在固定 60%。
五、它有多快,一共多少钱
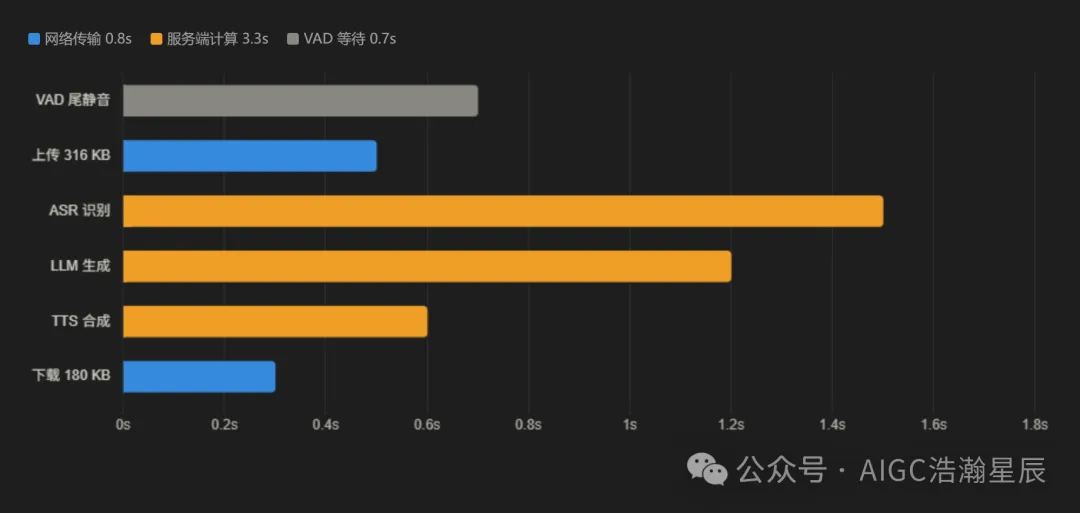
一次完整交互,端到端4.6 秒左右:
说完话等它确认你停了:0.5 秒 上传音频:0.5 秒 语音识别:1.5 秒 大模型回答:1.2 秒 语音合成:0.6 秒 下载回复:0.3 秒
我一开始以为瓶颈在网络——毕竟要传几百 KB 音频。算完账才发现完全不是。
16 kHz、16 位、单声道的音频,码率是固定的256 kbps,也就是每秒 32 KB。而 WiFi 的实际吞吐是 5~15 Mbps,差了将近两个数量级。传 300 KB 的录音,半秒都用不完。
真正的时间,69% 花在服务器上那三个串行的模型推理里。
这也顺带纠正一个常见误解:服务器慢就加内存。CPU 推理是算力密集,模型早就常驻内存了,加内存一分钱效果都没有。该加的是 CPU 核心数。
成本:一整套 70 出头
ESP32-S3 开发板(必须带 PSRAM):30 元 INMP441 数字麦克风:8 元 MAX98357A 功放:6 元 SSD1306 0.91 寸屏:5 元 小喇叭、杜邦线、按键:20 元
想做成能拿在手上的,再加 30 块左右:
18650 电池 + 电池座:15 元 升压模块(3.7V → 5V):5 元 拨动开关、外壳:10 元
一共100 元出头。
不过续航这事得说实话:WiFi 常开、常开聆听一直在跑 VAD,按电流估一块 2500mAh 的电池大概撑 8~12 小时,说话越频繁越短。
所以我现在还是插着电,把它架在灶台边。反正它服务的位置是固定的——灶台、床头、书桌。电池版更适合带出门、或者不想拉一根线到床头的人。
服务端那边,一台 2 核 4G 的云主机就够跑全部模型。
不想买服务器?其实不用买
这套东西的后端就是个普通程序,跑在你自己的电脑上完全一样。
玩法是这样:手机开个热点,电脑和这个小盒子都连这个热点。
于是设备到后端就在同一个局域网里,只隔一跳,不用绕公网。延迟比走公网低一截,而且不用公网 IP、不用备案、不用折腾内网穿透,声音也不出家门。
我现在出门演示就经常这么干:电脑塞包里,设备拿手上,手机一开热点,到哪儿都能跑。
三个小前提:手机热点要开2.4G 频段(ESP32 只认 2.4G,5G 连不上);配网页里的服务器地址填电脑的局域网 IP(端口 8000);电脑防火墙放行 8000。
哦对,还有一个:手机流量那一步绕不过去——大模型是云端 API,信号差的时候它会慢一点。语音识别和语音合成是电脑本地算的,不受影响。
六、它现在还不能做什么
我不想把它说得比实际更好:
没有离线唤醒词。所以「常开聆听」是持续在跑 VAD 的,会略微费电,也不适合长期电池供电。 短回复也要等 4 秒。因为有两个固定开销:双击判定窗口 300 毫秒、尾静音确认 500 毫秒。 iPhone 不能滑动。iOS 不允许非 MFi 认证的设备模拟触摸屏,这是系统限制。安卓全系可用。 还不能边下边播。现在的做法是等整段音频下载完再播放。
下一步想做的,是把「边合成、边下发、边播放」打通——大模型一边吐字,服务器一边按句合成语音,第一句好了就发给设备开始播。理论上首字延迟能从 4.6 秒压到 3.4 秒以内。
七、最后
这个项目最让我上瘾的地方,不是最后那个能对话的盒子。
是每一次「它不按我想的来」,背后都藏着一个具体的、可以被测量的原因。
VAD 不触发,是因为 448 毫秒里必然有气口;声音变噪声,是因为 TCP 分片长度是奇数;板子重启,是因为 192 KB 静态数组吃光了连续内存。
这些原因都不会自己浮出来。你得一行行看日志,一个个排除假设,然后某一刻突然对上——
时间戳差 2.003 秒,长按阈值 2000 毫秒。
那一下的快感,比做出成品强多了。
而这一切的起点,只是一个手上全是泡沫、够不到手机的晚上。
项目已开源:固件单文件、后端 Python,全部跑在自己机器上。想先看看长什么样:http://120.53.7.170:8000/(我自己的演示服务器,随时可能关掉)想看接线图和源码的,后台回「短剧」。

